Trong bài trước, mình có nhắc
rằng ReleaseFlow không có message broker: mọi việc nền chạy trên chính
PostgreSQL bằng FOR UPDATE SKIP LOCKED. Bài này đi vào chi tiết: nó hoạt
động thế nào, những chỗ dễ sai, và giới hạn của cách làm này.
Các đoạn code bên dưới lấy nguyên từ repo ReleaseFlow, chỉ rút gọn ở chỗ có ghi chú.
Bài toán: việc không được làm trong request
Khi một pull request được merge, GitHub gửi webhook pull_request tới
ReleaseFlow. Webhook đó cho biết pull request sửa bao nhiêu file, nhưng không
cho biết là những file nào. Mà danh sách file lại rất quan trọng: một pull
request tên chore: tidy nhưng sửa migration database, cấu hình security hay
workflow CI thì không thể để rule tự phân loại rồi đem release mà không ai nhìn
qua.
Lấy danh sách file cần một lời gọi API riêng, có xác thực, tới GitHub. ADR-0008 đặt ra ba điều kiện cho lời gọi đó:
-
không chạy trong request webhook — GitHub bỏ request sau mười giây;
-
không chạy trong một database transaction;
-
phải sống sót qua restart và qua lỗi tạm thời của GitHub.
Về sau, cùng chỗ đó còn có thêm lời gọi tới GitLab, Linear, Jira và AI. Nói cách khác, ReleaseFlow cần một hàng đợi.
Vì sao không dùng message broker
Câu trả lời quen thuộc là RabbitMQ, Kafka hay Redis. Nhưng ReleaseFlow đã có PostgreSQL, và mọi thứ một job cần — change, source, token đã mã hoá — đều nằm sẵn trong đó.
Điểm quyết định với mình là tính nguyên tử. Khi nhận webhook, ChangeIntake
ghi change và job xử lý của nó trong cùng một transaction:
// The change and its processing job are recorded together; changed files are
// collected and the change classified later, outside this call.
transactionTemplate.executeWithoutResult(status -> {
    Instant receivedAt = clock.instant();
    Change change = changeRepository.saveAndFlush(Change.received(/* ... */));
    jobRepository.save(new ChangeProcessingJob(UUID.randomUUID(), change, receivedAt));
});
Hoặc cả hai được commit, hoặc không cái nào. Nếu hàng đợi nằm ở một broker, mình sẽ phải xử lý trường hợp change đã lưu mà message chưa gửi được, hoặc ngược lại. Cách chữa quen thuộc cho chuyện đó là một bảng outbox — mà bảng đó lại nằm trong PostgreSQL.
Lý do thứ hai là ít thành phần thì dễ chạy. Bundle quickstart chỉ có hai service: ứng dụng và một PostgreSQL. Với một công cụ self-hosted mà mình muốn ai cũng chạy thử được bằng vài lệnh, bớt đi một dịch vụ là bớt đi một lý do để người ta bỏ cuộc.
Một bảng cho mỗi loại việc
ReleaseFlow không có một bảng jobs chung. Mỗi loại việc có bảng riêng, với cột
và ràng buộc riêng. Đây là bảng của việc xử lý change (đã rút gọn, gộp từ
migration V10 và V11):
CREATE TABLE change_processing_jobs (
    id UUID PRIMARY KEY,
    change_id UUID NOT NULL,
    status VARCHAR(20) NOT NULL,
    attempts INTEGER NOT NULL,
    next_attempt_at TIMESTAMP WITH TIME ZONE NOT NULL,
    claimed_at TIMESTAMP WITH TIME ZONE,
    completed_at TIMESTAMP WITH TIME ZONE,
    last_error VARCHAR(100),
    created_at TIMESTAMP WITH TIME ZONE NOT NULL,
    CONSTRAINT change_processing_jobs_change_unique UNIQUE (change_id),
    CONSTRAINT change_processing_jobs_status_known
        CHECK (status IN ('PENDING', 'ENRICHING', 'CLASSIFYING', 'FALLBACK_REQUIRED', 'COMPLETED')),
    CONSTRAINT change_processing_jobs_state_consistent CHECK (
        (status = 'COMPLETED') = (completed_at IS NOT NULL)
        AND (status NOT IN ('ENRICHING', 'CLASSIFYING') OR claimed_at IS NOT NULL)
    )
);
Mỗi cột trả lời một câu hỏi: next_attempt_at — khi nào job được làm;
claimed_at — ai đó nhận nó lúc nào; attempts — đã thử mấy lần;
last_error — lần trước hỏng vì sao. Các CHECK đảm bảo database không bao giờ
chứa một job "đã xong mà không có thời điểm xong", hay một job "đang chạy mà
chưa ai nhận".
Kèm theo là một partial index chỉ chứa những job còn đang chờ:
CREATE INDEX change_processing_jobs_due_idx
    ON change_processing_jobs (next_attempt_at, created_at)
    WHERE status IN ('PENDING', 'FALLBACK_REQUIRED');
Job đã xong — theo thời gian sẽ là gần như cả bảng — không nằm trong index, nên việc tìm job kế tiếp vẫn nhanh khi bảng lớn dần.
Cùng một khuôn đó được dùng lại cho năm worker:
| Worker | Chạy mỗi | Bảng | Việc |
|---|---|---|---|
|
giây |
|
Lấy thêm thông tin và phân loại một change |
|
giây |
|
Import lịch sử, và các lần poll Jira |
|
giây |
|
Dịch qua DeepL |
|
giây |
|
Biến một lần publish thành các lượt chạy, rồi gửi từng action một |
|
15 giây (mặc định) |
|
Đặt lượt chạy cho lịch cron và nhắc trước release; không bao giờ gọi provider |
Phần còn lại của bài dùng ChangeProcessingWorker làm ví dụ.
Nhận job: FOR UPDATE SKIP LOCKED
Đây là toàn bộ truy vấn nhận job:
// SKIP LOCKED lets several workers claim different jobs without waiting on each other.
@Query(value = """
        SELECT * FROM change_processing_jobs
        WHERE status IN ('PENDING', 'FALLBACK_REQUIRED') AND next_attempt_at <= :now
        ORDER BY next_attempt_at, created_at
        LIMIT 1
        FOR UPDATE SKIP LOCKED
        """, nativeQuery = true)
Optional<ChangeProcessingJob> lockNextDue(@Param("now") Instant now);
Từng phần của nó:
-
FOR UPDATEkhoá dòng được chọn cho tới khi transaction kết thúc. Không có nó, hai worker có thể cùng đọc một jobPENDINGvà cùng xử lý. -
Chỉ có
FOR UPDATEthì chưa đủ. Worker thứ hai sẽ đứng chờ đúng dòng mà worker thứ nhất đang khoá. Khi worker thứ nhất commit, dòng đó không còn khớp điều kiệnWHEREnữa, và worker thứ hai nhận về… không gì cả — dù có thể vẫn còn những job khác đang chờ. -
SKIP LOCKEDbảo PostgreSQL bỏ qua dòng đang bị khoá và lấy dòng kế tiếp. Mỗi worker nhận một job khác nhau, không ai phải chờ ai. -
ORDER BY next_attempt_at, created_atlấy job đến hạn sớm nhất trước, đúng thứ tự của partial index ở trên.
Worker là một method @Scheduled chạy mỗi giây. Mỗi lượt, nó nhận từng job một
cho tới khi không còn job nào đến hạn:
@Scheduled(fixedDelayString = "PT1S")
void processDueJobs() {
    if (!enabled) {
        return;
    }
    try {
        while (processOne()) {
            // Keep draining due jobs before sleeping again.
        }
    } catch (RuntimeException exception) {
        log.error("Change processing stopped unexpectedly; it resumes on the next tick.", exception);
    }
}
Vì SKIP LOCKED đã lo việc chia job, worker có thể chạy trong mọi instance của
ứng dụng mà không cần bầu ra một leader.
Transaction ngắn, mạng nằm ở giữa
Cái bẫy dễ rơi vào nhất là giữ transaction mở trong lúc gọi GitHub. Lời gọi đó có thể mất vài giây — GitHub trả 100 file mỗi trang, ReleaseFlow đọc tối đa năm trang. Trong suốt thời gian đó, transaction giữ một connection của pool và giữ khoá trên dòng. Chỉ cần vài lời gọi chậm cùng lúc là pool cạn, và request của người dùng phải xếp hàng sau một API ở tận đâu đó.
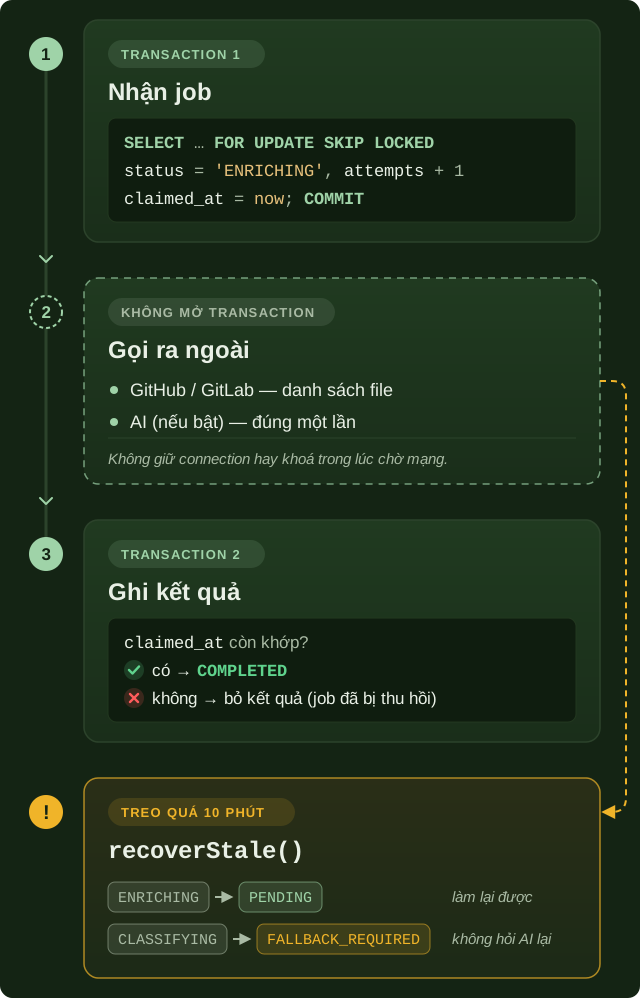
Vì vậy mỗi job đi qua ba bước, và lời gọi mạng không bao giờ nằm trong một transaction:
-
Transaction 1 — nhận job. Khoá job bằng truy vấn ở trên, chuyển nó sang
ENRICHING, tăngattempts, ghiclaimed_at, rồi commit. Khoá được nhả ngay. Từ đây thứ giữ job lại cho worker này không còn là khoá, mà là trạng thái: một jobENRICHINGkhông còn khớp điều kiệnWHERE, nên không worker nào khác nhận nó nữa. -
Không transaction — gọi ra ngoài. Lấy danh sách file từ provider, rồi gọi AI nếu được bật.
-
Transaction 2 — ghi kết quả, nhưng chỉ sau khi kiểm tra job vẫn còn mang claim của chính worker này.
Khi có AI, giữa hai lời gọi còn một transaction ngắn nữa: ghi danh sách file
vừa lấy được và chuyển job sang CLASSIFYING. Chi tiết nhỏ đó trở nên quan
trọng ở phần tiếp theo.
Khi worker chết giữa chừng
Giữ job bằng trạng thái thay vì bằng khoá có một cái giá. Nếu process bị kill
ở bước 2, sẽ không có transaction nào rollback giúp mình cả: job nằm ở
ENRICHING mãi mãi.
Nên mỗi lượt, trước khi nhận job mới, worker thu hồi những job đã bị nhận quá mười phút:
// A worker that died mid-call leaves its claim behind. Collecting files is safe to
// repeat, but an AI call is not: a stale CLASSIFYING job is completed without it.
@Modifying
@Query(value = """
        UPDATE change_processing_jobs
        SET status = CASE status WHEN 'CLASSIFYING' THEN 'FALLBACK_REQUIRED' ELSE 'PENDING' END,
            next_attempt_at = :now
        WHERE status IN ('ENRICHING', 'CLASSIFYING') AND claimed_at < :staleBefore
        """, nativeQuery = true)
int recoverStale(@Param("staleBefore") Instant staleBefore, @Param("now") Instant now);
Chỗ đáng chú ý là CASE. Một job ENRICHING quay về PENDING, vì lấy danh
sách file chỉ là đọc — làm lại cũng vô hại. Một job CLASSIFYING thì khác: lời
gọi AI có thể đã tới provider, đã tốn tiền, thậm chí đã có câu trả lời.
ReleaseFlow chỉ hỏi AI đúng một lần cho mỗi change, nên job đó chuyển sang
FALLBACK_REQUIRED. Lần nhận sau, nó được hoàn tất ngay từ danh sách file đã
ghi ở transaction trung gian, chỉ bằng rule, kèm một trigger
CLASSIFIER_FALLBACK buộc người phải review — và không bao giờ hỏi AI thêm lần
nào.
Còn một trường hợp khó hơn chuyện worker chết: worker chưa chết. Nó chỉ chậm, treo mười một phút, rồi tỉnh dậy. Trong lúc đó job đã bị thu hồi và một worker khác đã nhận lại. Nếu worker cũ cứ thế ghi kết quả, hai kết quả sẽ đè lên nhau.
claimed_at chính là tấm vé để chặn chuyện đó:
// True only for the worker holding the current claim; a claim that went stale and was
// taken over by another worker no longer belongs to it.
boolean isClaimedAt(Instant claim) {
    return (status == Status.ENRICHING || status == Status.CLASSIFYING) && claim.equals(claimedAt);
}
Mỗi lần ghi kết quả đều kiểm tra tấm vé trước:
ChangeProcessingJob job = jobRepository.findById(claim.jobId()).orElseThrow();
if (!job.isClaimedAt(claim.claimedAt())) {
    // The claim went stale and another worker took the job over.
    return null;
}
Worker mới nhận job thì ghi claimed_at mới, nên vé của worker cũ không còn
khớp và kết quả của nó bị bỏ đi.
Có một chi tiết nhỏ mà mình suýt bỏ qua: Instant của Java có độ chính xác tới
nano giây, còn PostgreSQL chỉ lưu tới micro giây. Nếu không cắt thời điểm về
micro giây trước khi ghi, vé đọc lại từ database sẽ không bao giờ khớp với vé
worker đang cầm — kể cả khi không có ai tranh job:
// PostgreSQL keeps microseconds, so a claim time must survive a round trip unchanged.
private Instant now() {
    return clock.instant().truncatedTo(ChronoUnit.MICROS);
}
Retry có giới hạn, và không bao giờ âm thầm bỏ qua
Retry ở đây không cần một delay queue riêng. Thử lại chỉ là đưa job về
PENDING với next_attempt_at lùi về sau, và chính truy vấn nhận job ở trên sẽ
nhặt lại nó khi tới giờ.
-
Lỗi tạm thời — timeout, lỗi mạng, rate limit, phản hồi 5xx — được thử lại sau 2 rồi 4 giây, tối đa ba lần.
-
Hết lượt, hoặc lỗi không đáng thử lại — không có token, GitHub từ chối token, phản hồi không hợp lệ, hay năm trang 100 file đều đầy: change vẫn được phân loại, nhưng kèm trigger
CHANGED_FILES_UNAVAILABLEđể buộc người review. Một danh sách bị cắt không bao giờ được coi là đầy đủ. -
Lỗi bất ngờ — một exception không ai lường trước — làm job được hẹn lại, và change vẫn hiện là Processing trong Change Inbox thay vì lặng lẽ biến mất.
Database cũng tự bảo vệ trong lúc đó. Ràng buộc changes_processing_unsettled
giữ một change đang PROCESSING ở trạng thái chưa thể release, chưa thể review
và chưa thể gửi cho AI — kể cả khi tầng service có bug.
Kiểm chứng trên PostgreSQL thật
Ở bài trước mình kể rằng mock chỉ trả lời đúng những gì mình nghĩ tới. Với khoá
thì còn rõ hơn: một database giả không có SKIP LOCKED. Nên test cho phần này
chạy trên PostgreSQL thật qua Testcontainers, với đúng các migration production:
@Test
void concurrentWorkersClaimEachJobOnce() throws Exception {
    Repository repository = connect(true);
    GITHUB.respondWithFiles("src/main/java/Export.java");
    GITHUB.delay(Duration.ofMillis(300));
    for (int number = 1; number <= 3; number++) {
        deliver(repository, number, "feat: change " + number);
    }

    ExecutorService executor = Executors.newFixedThreadPool(4);
    // ... bốn thread cùng gọi worker.processOne() cho tới khi hết job ...

    assertThat(jobRepository.findAll()).allSatisfy(job -> assertThat(job.getAttempts()).isOne());
}
Bốn worker tranh nhau ba job, và stub GitHub cố tình trả lời chậm 300 ms để các worker chắc chắn chạy chồng lên nhau. Test kiểm tra rằng cả ba change đều được xử lý xong, stub nhận đúng ba request lấy file — mỗi pull request một — và mỗi job chỉ được nhận đúng một lần.
Giới hạn, nói thẳng
-
Poll mỗi giây. Một job mới phải chờ tối đa khoảng một giây, và khi rảnh, mỗi worker vẫn hỏi database mỗi giây. Với nhịp độ của release note thì chuyện đó không đáng kể.
LISTEN/NOTIFYcó thể bỏ được độ trễ này, nhưng mình chưa cần tới. -
Nhiều instance. Worker được viết để chạy song song mà không cần leader, nhưng tài liệu vận hành vẫn khuyên chạy một instance: session đang nằm trong RAM, và CI chưa bao giờ chạy nhiều hơn một. "Được thiết kế cho" chưa phải là "đã được kiểm chứng".
-
Khi nào mình sẽ dùng broker? Khi nhiều hệ thống khác cần cùng nghe một sự kiện, khi lượng việc lớn tới mức một database không gánh nổi, hoặc khi team đã vận hành sẵn một broker. ReleaseFlow chưa rơi vào trường hợp nào trong ba trường hợp đó.
Tiếp theo
Bài sau sẽ nói về AI: làm sao để AI
chạy tự động mà con người vẫn là người quyết định. Đó cũng là lý do bài này có CLASSIFYING, FALLBACK_REQUIRED và quy tắc
"chỉ hỏi AI một lần".
Toàn bộ code nằm trong repo ReleaseFlow, và quyết định gốc được ghi ở ADR-0008. Nếu bạn từng làm hàng đợi trên PostgreSQL theo cách khác, hoặc thấy chỗ nào trong bài chưa đúng, hãy mở một Discussion trên GitHub.